
Profile Job Results
Jobs
jp1m3d27p
Results Ready
Name
whisper_large_v3_turbo_decoder
Target Device
- Snapdragon 8 Elite Gen 6 QRD
- Android 17
- Snapdragon® 8 Elite Gen 6 | SM8950
Creator
ai-hub-support@qti.qualcomm.com
Input Specs
input_ids: int32[1, 1]position_ids: int32[1]k_cache_self_0_in: float16[20, 1, 64, 199]attention_mask: float16[1, 1, 1, 200]v_cache_self_0_in: float16[20, 1, 199, 64]k_cache_cross_0: float16[20, 1, 64, 1500]v_cache_cross_0: float16[20, 1, 1500, 64]k_cache_self_1_in: float16[20, 1, 64, 199]v_cache_self_1_in: float16[20, 1, 199, 64]k_cache_cross_1: float16[20, 1, 64, 1500]v_cache_cross_1: float16[20, 1, 1500, 64]k_cache_self_2_in: float16[20, 1, 64, 199]v_cache_self_2_in: float16[20, 1, 199, 64]k_cache_cross_2: float16[20, 1, 64, 1500]v_cache_cross_2: float16[20, 1, 1500, 64]k_cache_self_3_in: float16[20, 1, 64, 199]v_cache_self_3_in: float16[20, 1, 199, 64]k_cache_cross_3: float16[20, 1, 64, 1500]v_cache_cross_3: float16[20, 1, 1500, 64]Completion Time
11/14/2026, 2:11:56 PM
Options
--qairt_version latestVersions
- ONNX Runtime: 1.30.0
- QNN Execution Provider: 2.5.0
- QAIRT: v2.51.0.260929181845
- Android: 17 (CQ2A.260820.002-CP2A.260605.016)
- Build ID: Maili.LA.1.0.r1-00252-STD.PROD-1
- AI Hub: aihub-2026.11.06.1
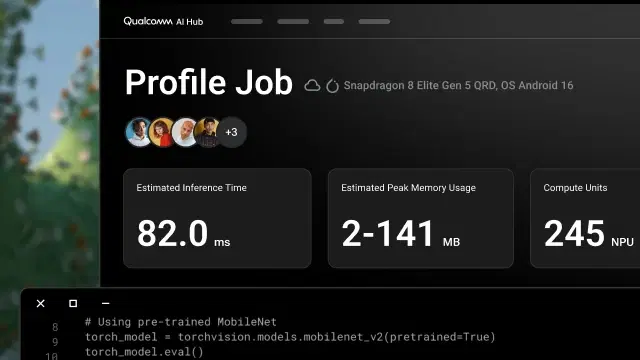
Estimated Inference Time
6.42 ms
Estimated Peak Memory Usage
42 ‑ 48 MB
Compute Units
NPU
1235
| Stage | Time | Memory |
|---|---|---|
First App Load | 209 ms | 440‑450 MB |
Subsequent App Load | 194 ms | 433‑440 MB |
Inference | 6.42 ms | 42‑48 MB |
| ONNX Runtime | Value |
|---|---|
| execution_mode | SEQUENTIAL |
| intra_op_num_threads | 0 |
| inter_op_num_threads | 0 |
| enable_memory_pattern | false |
| enable_cpu_memory_arena | false |
| graph_optimization_level | ENABLE_ALL |
| QNN Execution Provider | Value |
|---|---|
| htp_performance_mode | "burst" |
| htp_graph_finalization_optimization_mode | "3" |
| enable_htp_fp16_precision | "1" |
| capture_network_visualizations | false |
| context_priority | "normal" |
| offload_graph_io_quantization | "1" |
| num_graph_prepare_threads | "1" |
Sign up to run this model on a hosted Qualcomm® device!
Run on device